逐字"想"出回答:拆解大模型推理的四件套
上篇结尾我留了件小事:下次跟 AI 聊天,留意它是不是一个字一个字往外蹦的。你大概已经发现了——它确实在"逐字来"。这一篇,我们把镜头推到这块屏幕后面,看看那一行行字到底是怎么被"想"出来的。
答案藏在四个词里:Token、Prefill、Decode、KV Cache。我会把它们合称"推理四件套"。理解它们,你才算真正摸到了「推理」的门槛——而这,正是后面我们要把大模型塞进机器人身体之前,必须打好的地基。
Token:模型读的不是字,是"词块"
人读文章,是一个字一个字扫;但模型不吃"字",它吃的是 token。
token 是大模型处理信息的最小单位。一段文字进来,先被分词器(tokenizer)切成一串 token——可以是一个完整单词、半个词、甚至一个标点。英文里 "chat" 可能就是 1 个 token,"unbelievable" 常被切成 "un" + "believ" + "able" 三个;中文更碎,常常两三个字才凑成 1 个 token。粗略地说,1 个英文 token ≈ 0.75 个单词,1 个中文 token ≈ 1~2 个字。
(给个数据感:同样是"你好,请帮我写一份周报",中文和英文的 token 数往往差出好几倍——这也是为什么同样一段话,中英文之间的翻译与推理成本能差出一大截。)
不只是文字。多模态模型看一张图,也是把图切成一堆"视觉块"(visual patch),每个块当成 1 个 token 往里喂。所以"token"的准确含义是:模型世界里一切信息的最小打包单位。
为什么你要关心这个?因为 token 就是账本。模型按 token 收钱、按 token 算算力、按 token 排显存。一次对话贵不贵,首先看你吐了多少 token;一段上下文撑不撑得下,也看 token 总量。后面要聊的 Prefill、Decode、KV Cache,全都绕着 token 转。
Prefill:模型的"读题"时刻
好,用户输入了一长段 prompt。模型第一步做什么?
它把整段输入一次性塞进神经网络,从头算到尾,目标是产出第一个 token。这一步叫 Prefill(预填充),也有人叫它"prefill 阶段"。
打个比方:考试发卷,你先把整张卷子读一遍,在脑子里把题意和已知条件都过一遍——这一口气读完、想清楚"题目到底要我答什么"的过程,就是 Prefill。它一次性把全部输入 token 都处理掉,算出它们各自的隐藏状态,然后吐出第一个字。
Prefill 是整个推理里算力最密集的一步。因为它要同时算所有输入 token,做一次超大的矩阵运算。这一步的快慢,体现为 TTFT(Time To First Token,首 token 延迟)——用户点完"发送"到屏幕上出现第一个字,中间等了多久。
(数据感:在单卡 7B 量级模型上,处理一段一两千 token 的 prompt,Prefill 通常只要几十到几百毫秒;但如果 prompt 长到几万 token,TTFT 就会肉眼可见地拉长。)
一句话记住 Prefill:它是"读题",最烧算力,决定你等多久才看到第一个字。
Decode:自回归地逐字作答
第一个字出来了,接下来呢?
模型不会一次性把整段回答写完。它每吐出 1 个 token,就把这个 token 接在末尾,再算下一个——一个接一个,像挤牙膏。这一步叫 Decode(解码)。
这也就是你在屏幕上看到"逐字来"的真正原因:不是前端做了动画,是模型本质上就是一个字一个字往外生成的。这种"用已生成的词预测下一个词"的方式,专业名词叫自回归(autoregressive)。每一步都死死依赖上一步的输出——它得先说出"今",才想得出来"天",想完"今天",才接得上"天气"。
Decode 阶段的节奏,叫 TBT(Token Between Time,token 间延迟),也叫 TPOT(Time Per Output Token)。它衡量的是相邻两个字之间隔了多久。比如一个模型跑到 50 token/s,那它的 TBT 大约就是 20 毫秒——你几乎感觉不到停顿;但如果只跑到 10 token/s,TBT 就有 100 毫秒,你就能明显看到字在"蹦"。
(这里插一句回忆杀:上篇我们说,对一台要实时端水的机器人来说,TBT 是安全临界——它决定了机器人"反应"够不够快。你现在知道 TBT 到底是什么了。)
Decode 每一步其实很"亏":明明只新生成了 1 个 token,却要把整个模型权重从显存里再搬一遍来算它。所以 Decode 阶段通常是显存带宽(memory bandwidth)受限,而不是算力受限——这也解释了为什么"让模型吐字更快"和"让模型读题更快"是两种完全不同的优化思路。
KV Cache:让"吐字"流畅的草稿纸
Decode 有个天生麻烦。如果不用任何技巧,每生成 1 个新 token,模型都得把前面所有 token 重新算一遍——历史越长,这一步越慢,复杂度直接飙到 O(n²)。这显然不行。
于是有了 KV Cache(键值缓存)。
道理跟草稿纸一模一样:你解一道长题,不会每写一行就把前面全部重算,而是把中间结果记在草稿纸上,写新一行时瞄一眼就行。KV Cache 干的就是这个——模型把已经算过的每个历史 token 的 Key 和 Value(注意力机制里的两个中间结果)缓存下来;之后每生成一个新 token,只要算"新 token 的 Query"去和缓存里的 K、V 比对就行,不用重算整段历史。
这正是"逐字来"还能保持流畅的秘密:不是每步都从零开始,而是站在草稿纸的肩膀上往前走。
但草稿纸要占地方。KV Cache 实打实地吃显存:
一个 token 的 KV 缓存大小 ≈ 2(K 和 V)× 层数 × 每层 KV 维度 × 每个元素的字节数
以 7B 量级、FP16 精度为例,大约每 1 千个 token 的 KV 缓存就要吃掉约 0.5GB 显存。一段 4K 的上下文、单轮对话,光 KV Cache 就奔着 2GB 去了;要是多轮长对话、再叠几个并发用户,显存很快就被草稿纸堆满。
这也就解释了两个常见现象:为什么长上下文模型特别吃显存?因为草稿纸越铺越长。为什么多轮对话越聊越慢、越聊越贵?因为每一轮都要在草稿纸上追加新内容。理解 KV Cache,你就理解了"上下文长度"和"并发数"背后的真实成本。
调度:把"单次贵"摊成"批量便宜"
讲到这儿,四件套齐了。但还有一个问题:上面这些,都是"一次请求"的视角。真实服务里,是成百上千人在同时问。
这就轮到调度机制登场,它决定了同一张 GPU 到底能同时伺候多少人。
第一个关键招数是连续批处理(continuous batching)。传统做法是等一整批请求都生成完再换下一批,慢的拖死快的;连续批处理则像一个聪明的餐厅领班——谁这道菜(token)炒好了就先上,空出来的灶台立刻接新单。这样多个请求的 Decode 步骤在 GPU 上交错进行,显存和计算都不浪费。
第二个是前缀缓存(prefix cache)。很多请求的"系统提示词"或开头几句话是一样的,比如"你是一个乐于助人的助手"。与其每个人都重算一遍这段共同前缀,不如算一次、缓存下来,后续请求直接复用。这又省下一大笔 Prefill 的算力。
把这两招合起来,效果就是:单个请求看起来很贵,但几十上百个请求共享同一张卡、复用同一段前缀,平均到每个人头上就便宜了——单位吞吐(tokens/s)被显著拉高。
(这里该想起上篇那句话了吧:同一个模型,部署方式不同,成本能差出几十倍。你现在知道那"几十倍"里,至少有一大块是调度和缓存的功劳。)
一次对话请求的完整链路
把前面四件套串起来,一次对话请求的完整处理链路是这样的:
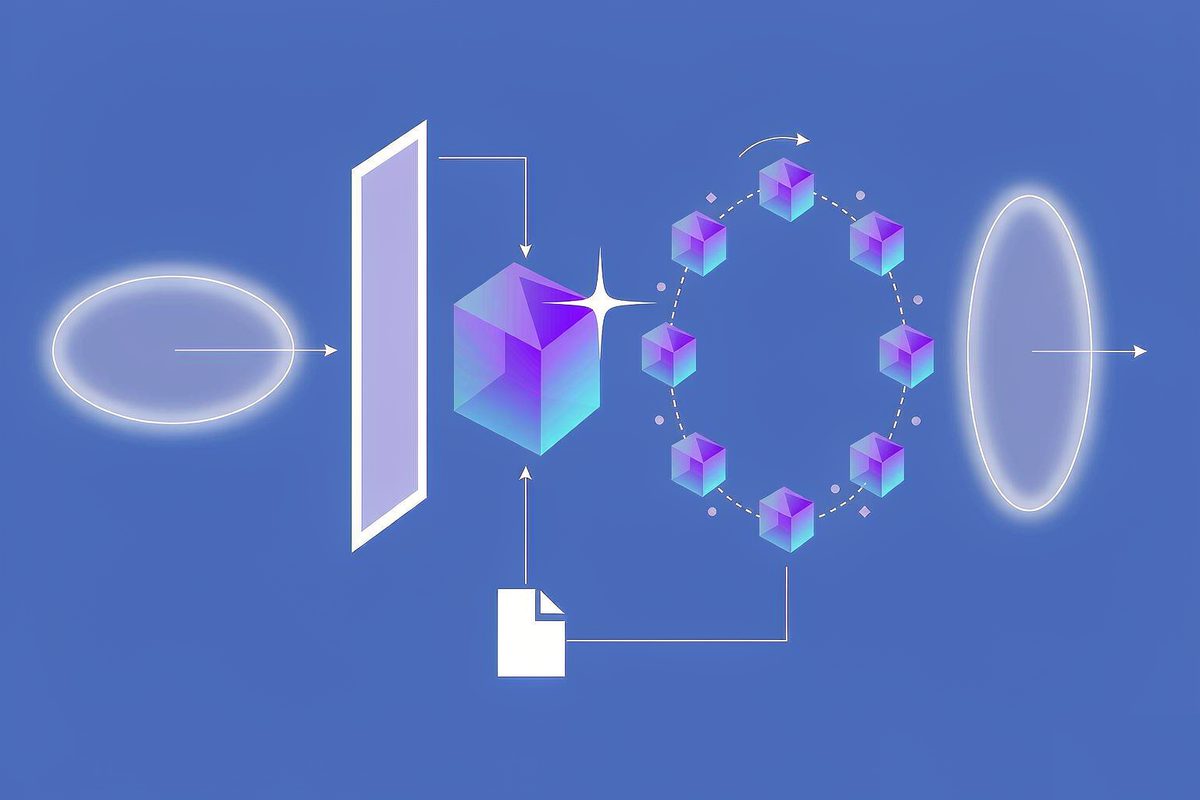
输入先走 Prefill,一口气读完题、产出第一个字;接着进入 Decode,一个字一个字往外蹦,而每一步都靠 KV Cache 这张草稿纸持续供给历史信息。Prefill 定 TTFT,Decode 定 TBT,KV Cache 定能撑多长,调度定能同时伺候多少人。
把 TTFT 和 TBT 算成一笔账
举个小例子把前面串起来:假设一个 7B 模型,TTFT 约 200ms,TBT 约 20ms(也就是 50 token/s)。如果它要回答约 150 个 token(差不多 200 字),用户从点发送到看到最后一个字,总耗时大约是:
200ms(等首字)+ 150 × 20ms(逐字吐)= 200ms + 3000ms ≈ 3.2 秒
你看,Prefill 决定那"开头的一顿",Decode 决定后面"字字紧跟还是磕磕绊绊"。这两个数字,到下一篇我们会拿它们当尺子,去量一量"快"和"贵"。
下一篇,我们聊"快不快、贵不贵"
现在我们知道了一轮对话是怎么一段段跑起来的:从 token 切分,到 Prefill 读题、Decode 作答、KV Cache 托底,再到调度把成本摊薄。
但还有几个更接地气的问题没回答:TTFT 和 TBT 到底到多少才算"够快"?吞吐和延迟之间怎么权衡?以及——既然大模型这么吃显存又这么慢,我们能不能把它"压一压"再塞进机器人身体里?这就引出下一期的两个主角:量化,以及如何用更少的资源跑出能用的速度。
读后小测
3 句话复述
1. 大模型先把输入切成 token(最小信息单位),Prefill 阶段一口气读完题、产出第一个字,延迟表现为 TTFT。 2. Decode 阶段自回归地逐字生成,每步依赖上一步,节奏由 TBT 决定,这就是"逐字来"的来源。 3. KV Cache 缓存历史 token 的 Key/Value 避免重算,让吐字流畅但占用显存;调度(连续批处理、前缀缓存)再把单次贵摊成批量便宜。
1 件动手小事
打开任意一家大模型的 API 文档或 playground,故意发一段很长的 prompt(比如贴一篇长文进去),再发一段很短的 prompt,分别感受一下"第一个字出来"等了多久——那就是 TTFT 的体感差异。下次我们聊量化时,你会感谢今天记住了这两个数字。