从一个聊天机器人到一台机器人:推理,为什么是具身智能看不见的地基
一、一个生活化的画面:机器人端起一杯水
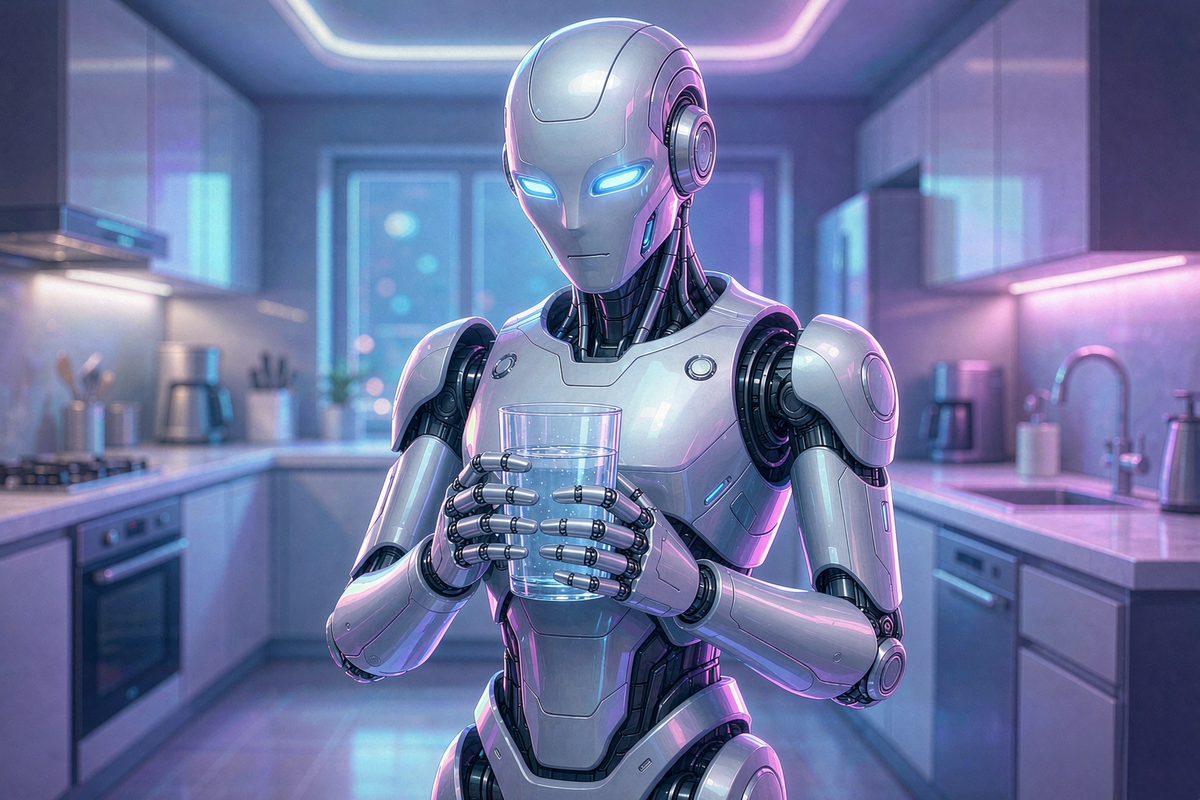
想象这样一个画面:你窝在沙发上,对厨房里的人形机器人说了一句"帮我端杯水来"。它转过身、走向饮水机、俯身、伸手、握住杯壁、稳稳端起、转身走回,把杯子轻轻放在你面前的茶几上——全程不到 10 秒,水没洒一滴。
对你来说,这是再自然不过的一件小事。但对这台机器人背后的"大脑"来说,这 10 秒里发生了一场极其密集的计算接力:
- 感知(Perception):摄像头和传感器在每一帧画面里认出杯子在哪、离手多远、桌面多高;
- 决策(Decision):大脑实时算出"先迈哪条腿、手伸多高、用多大力",并在每一步重新规划;
- 执行(Control):电机按指令转动,关节、手指做出动作;
- 反馈(Feedback):水晃了一下?立刻微调姿态。杯子偏了?重新校正抓握。
这四个环节不是"想好了再动",而是以几十赫兹的频率循环往复——每秒几十次"看一眼、想一下、动一下"。这,就是机器人比一个聊天机器人多出来的东西:身体,以及身体带来的物理约束。
先用一张图给你一个直观的画面感——机器人是怎么"端"起这杯水的:
把这条链路画出来,会是这样一个闭环:
而一个聊天机器人呢?你敲下回车,它"想"几秒,吐出一段文字。没有身体,没有实时回路,慢一点顶多你多等两秒。
区别就在这里:chatbot 的思考是"离线"的,机器人的思考是"在线"的、嵌入物理世界的。这篇开篇,我们要把这个区别讲透——并且让你明白,为什么"推理"(Inference)这件事,会从 chatbot 时代的一笔"成本账",变成机器人时代的一条"安全红线"。
二、先算一笔 chatbot 的账:同样的模型,花多少钱、等多久,全看怎么部署
在聊机器人之前,我们得先把自己熟悉的世界算清楚。
你一定用过 ChatGPT、Claude 或本地的开源模型。有没有想过:为什么同一个模型,有人用起来又快又便宜,有人却慢得让人想砸键盘、账单高得吓人?
答案不在模型本身,而在推理框架——也就是模型"跑起来"的那套软件与硬件组合:怎么把你的请求切成批次、怎么管理显存、怎么调度 GPU、用不用量化压缩……这些工程选择,直接决定了两个你最在意的数字:
- 每次回答要花多少钱(成本);
- 你要等多久才看到字(延迟)。
举一个简化的对比(数字为示意,便于建立直觉):
| 部署方式 | 典型硬件 | 单次回答成本 | 首字延迟 | 适合场景 | | --- | --- | --- | --- | --- | | 云端大模型 API | 集群级加速卡 | 较高,按 token 计费 | 数百毫秒 | 通用问答、写作 | | 自建推理服务(优化框架) | 单卡推理卡 | 中等,摊薄后很低 | 百毫秒级 | 高并发产品 | | 本地量化小模型 | 个人显卡 / 笔记本 | 近乎为零 | 几十毫秒 | 隐私、离线 | | 未优化的原始部署 | 通用服务器 | 高且浪费 | 数秒 | 不推荐 |
看明白了吗?模型一模一样,只是"怎么跑"不同,成本能差出几十倍,延迟能差出几个数量级。这就是为什么我说——推理框架,决定了你每次花多少钱、等多久。它不是锦上添花,而是地基。
这也是我们要帮你建立的第一组直觉:在 chatbot 世界里,推理的取舍主要是"省钱"和"省时间";到了机器人世界,它会变成"保命"。
三、核心矛盾:模型越大越聪明,但"身体"越跑不动
好,现在我们把 chatbot 换成了机器人。
你肯定听过这样一个规律:模型越大,通常越聪明。参数从 70 亿涨到 700 亿、7000 亿,理解力、推理力、泛化能力肉眼可见地提升。对机器人来说,一个大模型意味着它能看懂更复杂的场景、做更聪明的决策——这正是我们想要的。
但问题来了。chatbot 跑在云端机房里,那里有取之不尽的电、吹不垮的空调、塞得下的整排服务器。机器人呢?
- 算力约束:机器人本体能带的芯片,算力顶多相当于一块边缘级加速卡,和云端集群差着几个数量级;
- 功耗约束:它靠电池供电,多跑一秒大模型,续航就少一截;
- 散热约束:人形机器人身体里塞满电机和电路,再加一个发热的 AI 芯片,热量往哪散?
- 体积约束:芯片、电池、散热片都要占地儿,挤占了本该留给关节和传感器的空间。
把算力、功耗、散热、体积这四重约束画出来,就像四堵墙把机器人围在中间——它想变大变聪明,墙壁却在向内收缩:
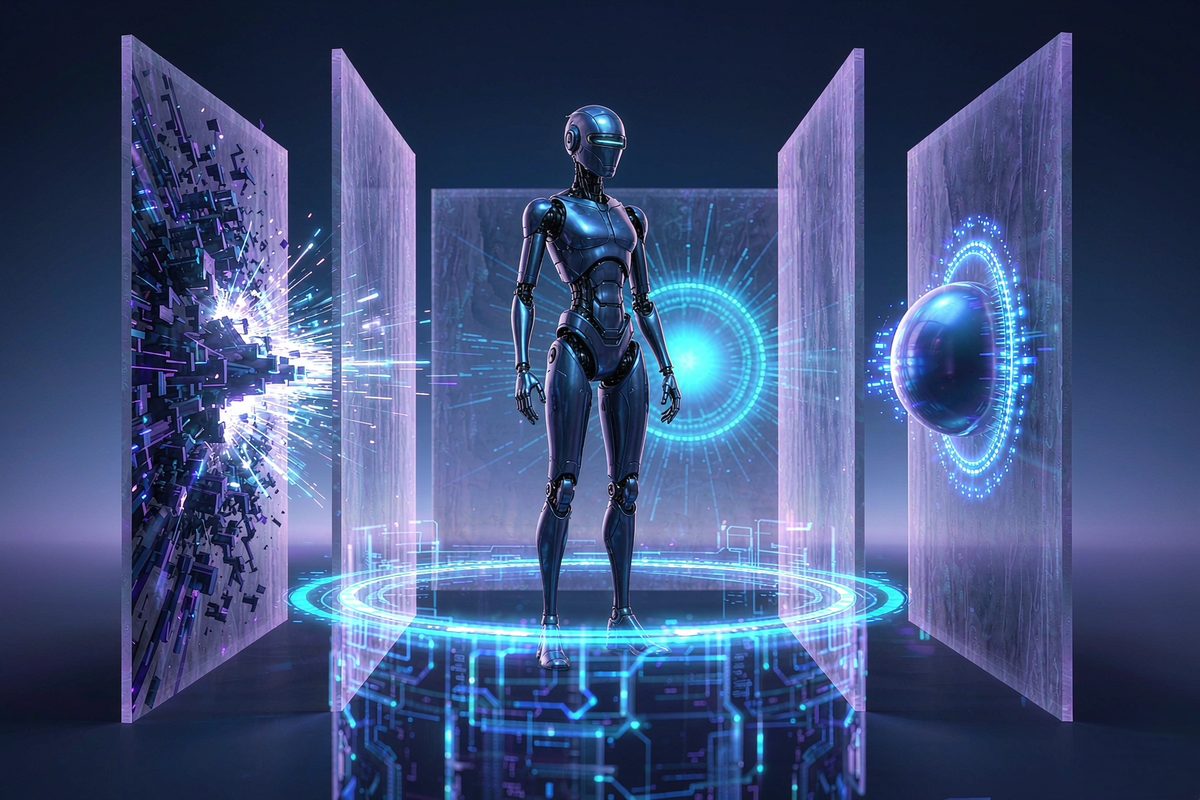
这就是机器人落地最尖锐的矛盾:
我们想塞进一个越聪明越大的"脑",但"身体"根本跑不动它。
四重约束像四堵墙,把"直接用云端大模型"这条路堵死了。你不能在机器人头顶接一根网线连到机房——那它一步都走不远,而且一旦断网,立刻"死机"。
于是问题从"模型够不够聪明"变成了"怎么让聪明的模型,在又小又穷又热的身体里跑得动、跑得稳"。这,正是"具身智能·推理部署"要啃的硬骨头。
四、机器人场景,只会比 chatbot 更残酷
你可能会想:chatbot 不也讲究快吗?机器人又能残酷到哪去?
残酷在延迟是有物理后果的。
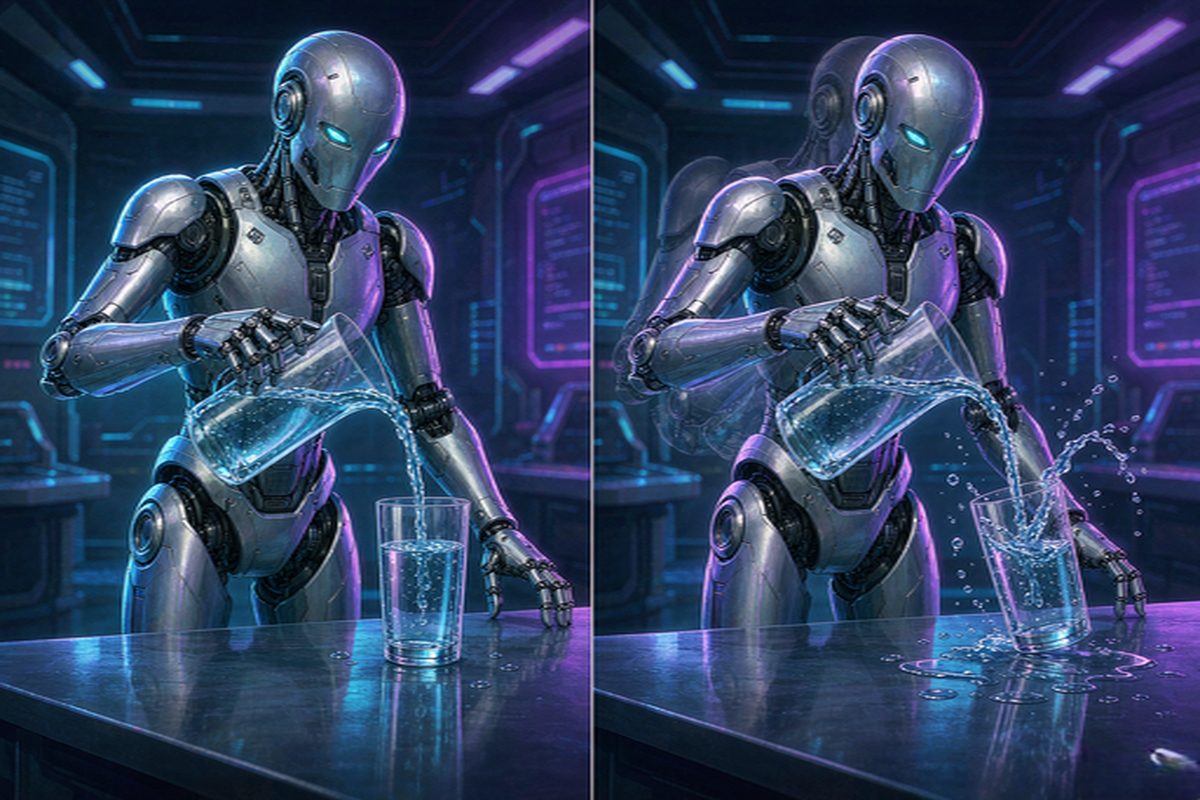
在 chatbot 里,首字延迟高一点,你只是多等两秒;吞吐低一点,只是并发上不去。但在机器人里,有一个指标叫 TBT(Time Between Tokens,token 间延迟)——它衡量的是模型"吐字"的节奏。对人类聊天,TBT 高只是读着累;对机器人,TBT 直接关联着"动作是否连贯、安全":TBT 一高,机器人的动作就可能卡顿、迟滞,在端水、避障、与人协作时,这卡顿就是事故。
换句话说,chatbot 世界里"慢一点无所谓"的容忍度,在机器人世界里被彻底清零——而这,正是 TBT 会成为机器人安全临界 的根本原因。
下面这张对比图很说明问题:左边是推理节奏流畅的机器人,端水稳稳当当;右边是 TBT 过高、动作卡顿抖动的机器人,水直接洒了出来——同一个动作,差的只是"吐字"的节奏,结局却天壤之别:
再往深想一层:机器人不能永远连着云,它得在本体或就近的边缘设备上跑模型。于是边缘部署成为绕不开的课题:怎么把动辄几十 GB 的模型塞进巴掌大的加速卡,怎么在功耗和精度之间走钢丝。
记住这句话,它会贯穿我们对具身智能的全部讨论:
机器人场景的推理,只会比 chatbot 更残酷——因为在这里,延迟是用物理代价、甚至是安全代价来买单的。
读后小测
3 句话复述
1. 推理框架决定同一个模型"怎么跑",部署方式不同,同样的模型成本和延迟能差出几十倍,所以它是地基而非锦上添花。 2. 机器人想用更大的模型变聪明,却被算力、功耗、散热、体积四重约束卡住,身体根本跑不动聪明的"脑"。 3. 机器人推理比 chatbot 更残酷,因为延迟有物理后果:TBT(token 间延迟)直接关联动作是否连贯安全,是机器人的安全临界。
1 件动手小事
今晚用手机上的任意一个 AI 聊一句复杂问题,顺手看一眼它"吐字"的节奏——留意从你发问到第一个字出现花了多久,以及后面字与字之间是不是均匀流畅。把这种"慢慢想、逐字来"的体验记在心里,下一篇我们拆开推理的"四件套"时,你会突然明白:为什么这套在聊天里无伤大雅的节奏,到了机器人身上,却可能变成一次端水翻车的事故。