TTFT、TBT、吞吐与量化:chatbot 的成本与速度账
上篇结尾我留了个悬念:既然大模型这么吃显存又这么慢,我们能不能把它"压一压",再塞进机器人身体里?
在动手"压"之前,得先把尺子备好。前面两篇我们讲了"推理为什么是地基"(第 1 篇)、"一轮对话怎么一段段跑起来"(第 2 篇)。这一篇,基础篇收官,我们要把这件事算成一笔账——到底什么在决定一个 chatbot "快不快、贵不贵",以及为什么"又快又多又省"几乎是个不可能三角。
把账算清,下一程往机器人身体里塞模型时,你才知道该往哪儿使劲。
一、先把三个数字钉在心里
衡量一次推理"快不快、贵不贵",核心其实是三个互相独立的指标。它们分别由上一篇文章讲的四件套里的不同环节决定:
- TTFT(Time To First Token,首 token 延迟):你点完"发送"到屏幕上蹦出第一个字,中间等了多久。它由 Prefill(读题) 决定——输入越长、模型越大,这一步越重。
- TBT / TPOT(token 间延迟):第一个字出来之后,相邻两个字之间隔了多久。它由 Decode(逐字作答) 决定,也正是我们第 1 篇强调的、机器人"逐字来"节奏的来源。
- 吞吐(throughput,tokens/s):单位时间里,这张卡总共能吐出多少 token。它不取决于单次请求的快慢,而取决于 调度(连续批处理、前缀缓存)——也就是"同一张卡能同时伺候多少人"。
一句话记忆:Prefill 定 TTFT,Decode 定 TBT,调度定吞吐。这正好把第 2 篇的四件套收了个尾。
把三者画成一张"指标归谁管"的图,关系非常干净:
(给个数据感,以下数字均为示意、便于建立量级直觉,不代表精确实测:在单卡 7B 量级模型上,一段不算长的 prompt,TTFT 常在百毫秒级;若跑到 50 token/s,TBT 大约就是 20 毫秒,你几乎感觉不到停顿;而靠连续批处理,单卡聚合吞吐可以做到数百到上千 tokens/s 这个量级。换更大的模型、更长的输入,这些数字会显著变化。)
二、一个三角:快、多、省,为什么不能全都要
现在问题来了。作为服务的设计者,你当然希望:TTFT 低(用户秒看首字)、TBT 低(吐字丝滑)、吞吐高(一张卡养活一堆人)。
可惜这三件事,经常是此消彼长的。
举两个最典型的牵制:
- 想压低 TTFT / TBT,最朴素的办法是堆算力——上更大的卡、更高的显存带宽。但算力是要花钱的:你压低了延迟,往往牺牲的是成本,或者牺牲了"能同时跑多少人"(吞吐)。
- 想拉高吞吐,最管用的招是连续批处理,让多个请求在同一张卡上交错 Decode。但批一大,单个请求就要和别人"抢"计算资源,它自己的 TTFT / TBT 反而可能被抬高——也就是"大家都快,但每个人都慢一点"。
这就是为什么我说它们是个"取舍三角"。用第 1 篇那套直觉来翻译,就是你得在 快 / 多 / 省 / 稳 / 准 之间做权衡:
- 快(TTFT、TBT 低):用户体感好,但烧算力;
- 多(吞吐高):能伺候更多人,但单请求可能变慢;
- 省(成本摊薄):靠批处理和缓存,但调不好两头不讨好;
- 稳(延迟不抖):需要留余量,又吃掉一部分"省";
- 准(回答质量):模型不能太小,否则回到"身体跑不动聪明脑"的老问题。
没有免费的午餐。你总得先想清楚:这个场景里,哪个指标是命?对 chatbot,通常是"别让用户等"和"别让账单爆";对机器人(回看第 1 篇那个端水画面),TBT 还会直接变成安全临界。指标一样,优先级天差地别。
三、给模型"瘦身":量化到底干了什么
既然"又大又准"和"又快又省"在打架,一个自然的念头是:能不能让模型本身变小一点,但别太掉精度?
这就是 量化(quantization)。
一句话:量化是把模型权重从"高精度浮点"压到"低比特整数 / 低比特浮点"。原来每个参数可能用 FP16(16 位浮点,2 字节)甚至 FP32 存着;量化后,可以压成 FP8(8 位浮点)、INT8、甚至 INT4(4 位整数,半字节)。
常见的几样东西,先混个脸熟:
- FP8:8 位浮点,精度损失小、对硬件友好,是数据中心推理的当红选择。
- INT4 / INT8:整数低位宽,压缩比高,常见于把大模型塞进消费级显卡。
- GGUF:一种模型文件格式(常配合 llama.cpp 使用),把量化后的权重打包好,是本地 / 消费级部署里最常见的"载体"之一。你电脑上跑的开源模型,很多就是这个样子。
为什么量化后 Decode 反而更快? 还记得第 2 篇说的:Decode 阶段不是算力受限,而是 显存带宽受限——每吐 1 个 token,都得把整份模型权重从显存里再搬一遍。权重变小了,"搬"的数据量就小了,搬得自然更快。换句话说,量化直接松开了 Decode 最紧的那根弦。
但天下没有白瘦的午餐,代价是:
- 精度损失:低位宽存不下那么细的信息,某些任务会"掉点";
- 挑任务:数学推理、长上下文、复杂指令跟随,往往比闲聊更怕量化;
- 不能一刀切:工程上常做混合精度,关键层留高精度,非关键层压低位宽。
所以量化不是"无脑压到底",而是在精度可接受的前提下,把位宽压到刚好够用。
四、一张直觉图:FP16 vs INT4,显存降到约 1/4
把"瘦身"换算成显存,是最直观的。下面是个参考示例(量级示意,具体数值随模型结构、框架、量化方案不同而变化):
以 7B 量级模型为例,权重本身在 FP16 下大约需要 14GB 量级(70 亿参数 × 2 字节);压到 INT4 后大约 3.5GB 量级(70 亿 × 0.5 字节)——差不多是原来的 1/4。
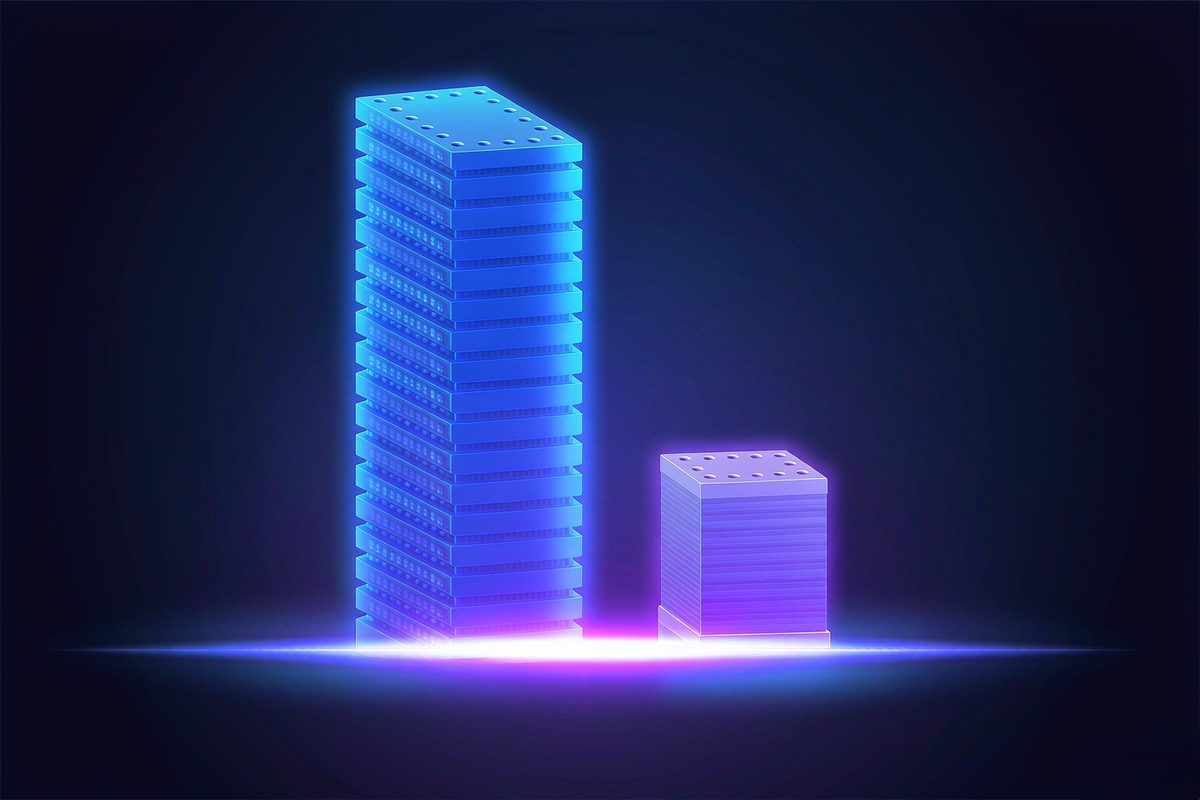
请注意,这是"权重"部分的粗算,还没算 KV Cache(第 2 篇那张吃显存的草稿纸)和激活值。但结论的方向很稳:量化让一份大模型从"得塞进数据中心级显卡",变成"能塞进一张消费级显卡、甚至笔记本或边缘卡"。
而这,正是下一程的起点。基础篇我们一直在 chatbot 的世界里打转——把推理拆成四件套、把速度成本算成账、用量化给模型瘦身。可机器人要的不是"在机房里跑得动",而是"在身体里跑得动、跑得稳"。
五、基础篇收官:模型够聪明了,但硬仗在后面
到这篇为止,基础篇(1–3)收口了:
1. 第 1 篇:推理是具身智能看不见的地基——同一个模型,部署方式不同,成本和延迟能差几十倍;机器人还多一重物理约束,TBT 是安全临界。 2. 第 2 篇:拆开推理四件套——Token、Prefill、Decode、KV Cache,外加调度,一轮对话就这么一段段跑起来。 3. 第 3 篇(本篇):把快和贵算成账——TTFT、TBT、吞吐三者此消彼长;量化给模型瘦身,让显存降到约 1/4,把"塞进边缘"变成可能。
地基打完了。模型够聪明了,瘦身的方法也有了。
但要让它在机器人身体里跑得动、跑得稳,接下来才是硬仗。下一篇起,我们正式走进具身篇——怎么把刚刚瘦身好的模型,真正塞进一台机器人的本体或就近的边缘设备里,在功耗、散热、延迟的夹缝中,让它既聪明又听话。
那是另一场关于"约束"的仗。我们具身篇见。
读后小测
3 句话复述
1. TTFT 由 Prefill 决定(等多久看首字)、TBT 由 Decode 决定(逐字节奏)、吞吐由调度决定(能同时伺候多少人),三者常常此消彼长,是个快 / 多 / 省 / 稳 / 准 的取舍三角。 2. 量化把模型权重从高精度浮点压到低比特整数 / 浮点(如 FP8、INT4),权重变小让 Decode 因带宽受限反而更快,代价是部分任务精度掉点;GGUF 是本地 / 消费级部署的常见载体。 3. 同一模型量化到 INT4 后显存大约降到 FP16 的 1/4(示意量级),让"塞进笔记本 / 边缘卡"成为可能,这正是具身篇"边缘部署"的起点。
1 件动手小事
今晚在你自己的电脑或一张消费级显卡上,试着跑一个量化过的小模型(比如某个 INT4 / GGUF 版本的开源模型,配合本地推理工具),再对比着回忆云端大模型 API 的体感:同样一句"帮我写一段代码",本地量化模型的首字延迟和吐字节奏大概怎样?把"模型变小、显存变省、但可能略掉点"这种 trade-off 亲手摸一遍——下一篇我们聊边缘部署时,你会立刻明白为什么"瘦身"是机器人落地的第一道门槛。