前沿展望:端侧大模型 + 世界模型,具身推理的下一个十年
基础篇三篇打地基、具身篇六篇铺链路,到这一篇,我们走到了专题的第十篇,也是收官。前九篇我们把"模型怎么在物理世界里跑起来、又怎么跑得稳"这件事从指标拆到了护栏。最后这一程,我们把镜头从"今天怎么跑"抬起,看一眼"下一个十年往哪走"——端侧大模型,和世界模型。
一、端侧大模型:模型越跑越小,脑越装越近
还记得第 3 篇我们聊量化吗?同一份大模型压到 INT4,显存大约降到原来的 1/4;第 5 篇我们又把它真正塞进了 Jetson、地平线、昇腾这类边缘芯片——靠量化、蒸馏、稀疏化三板斧,让"聪明脑"从机房搬到了机器人本体。
这条线今天还在往下走,而且越走越激进:模型不是"勉强跑得动",而是"越跑越小、越能装进本体"。一个最明确的趋势是端侧多模态——视觉、语言、动作被统一进同一个模型,不再需要"摄像头一个模型、语言一个模型、控制一个模型"各管一摊。
近况级的方向已经能看见雏形:一类是端侧 VLA,把"看画面直接出动作"的视觉-语言-动作模型,直接跑在机器人本体的边缘芯片甚至手机 SoC 上;另一类是手机或本体直接跑多模态,你口袋里的芯片开始能同时理解图、文、还有"接下来该做什么",而不用每次都把数据传回云端。
为什么这件事重要?回到第 4 篇那句话:机器人多一重物理约束,TBT 是安全临界。把推理搬到离传感器和执行器更近的地方,延迟更短、断网也能动——"脑"离"身体"越近,反应才越跟得上物理世界。
二、世界模型:从"预测下一个 token"到"预测下一个世界状态"
如果端侧大模型解决的是"脑放哪",那下一个十年更根本的变化,是"脑怎么想"。
chatbot 的推理范式,我们第 2 篇就拆过:自回归,预测下一个 token。模型一个字一个字往外蹦,本质是"根据已说的,猜下一个词"。这套范式到了机器人身上,被改造成了"根据已看的,猜下一个动作"。
世界模型(World Model) 要改的,正是这个"猜"的对象。它不再只预测"下一个 token / 下一个动作",而是预测"下一个世界状态"——也就是:如果我这么做,眼前这个世界下一刻会变成什么样?
把两种范式摆在一起,差别就清楚了:
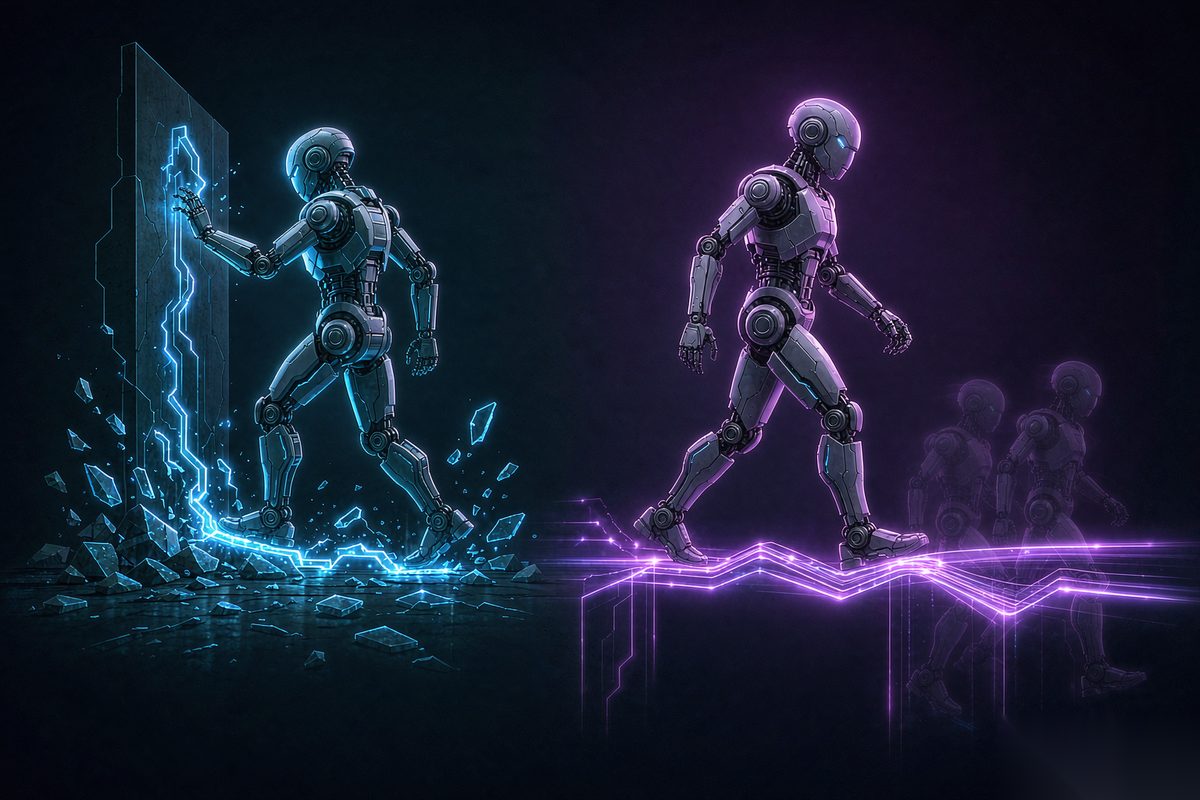
三、为什么世界模型能省下"延迟—安全"的账
光说"预测世界状态"有点虚,关键在它怎么帮到第 4 篇反复强调的 TBT 与安全临界。
回忆第 7 篇拆的"六站"链路:摄像头→感知→决策→执行,一环扣一环,每一环都吃时间。传统做法是"真走一步、看一步"——模型输出一个动作,机器人真动了,传感器再回采,再决定下一步。这每一步都是真实世界里的真实耗时,也是真实的风险:第 4 篇说过,控制环路掉一帧就可能撞墙。
世界模型换了个活法:它在"脑内"先开一场模拟。给定当前状态,它先在内部推演"如果往左走会怎样、如果刹车会怎样、如果抓这里会怎样",把多种可能都跑一遍,再挑一个最稳的、代价最小的那一步去真做。真实世界里它只走一步,但这一步是"想清楚之后"走的。
这正好接上第 4 篇的"肌肉记忆 / KV Cache"——KV Cache 让连续决策前后连贯,世界模型则让决策之前先有"内部预演"。一个是记住历史,一个是推演未来。两件事合起来,机器人从"凭本能反应"升级到"带预判的反应",真实试错的次数、以及随之而来的延迟—安全代价,都被大幅砍掉。
四、把 10 篇串起来:通用具身智能还差几步
走到收官,我们其实已经把"让模型在物理世界跑起来"的地基铺完了。但读者最想问的那个问题还在:具身智能,离"通用"到底还有几步?
别喊口号,给一张可判断的地图。沿着本专题串过的几条线,把关键维度拉出来分个级:
| 维度 | 今天到哪了 | 还差几步 | | --- | --- | --- | | 数据 | 真实交互数据稀缺又贵,靠遥操作与仿真合成 | 仍需海量、多样、可标注的真实数据,短期难补齐 | | 仿真 sim-to-real | 域随机化、延迟注入已能用,长尾仍掉链子 | 跨材质 / 光照 / 动力学的泛化,仍需攻坚 | | 安全护栏 | 结构化输出 + 可控采样 + 急停已成形(第 9 篇) | 形式化验证、可证明安全仍是前沿 | | 成本 / 功耗 | 量化 + 边缘部署已把模型塞进本体(第 3、5 篇) | 实时多模态大模型仍吃算力,需持续降本 | | 世界模型成熟度 | 视频预测 / 潜空间模拟初步可用 | 高保真、可因果推理的世界模型,仍需突破 |
判读很简单:数据、成本两条,今天已"够用但不够好",是近期能继续啃下来的;仿真泛化、安全证明两条,是中长期硬骨头;而世界模型的成熟度,是决定"通用"能不能真正到来的那块最关键拼图——它成熟了,前面几条线的压力都会松下来。所以"还差几步"的诚实答案不是"再等一个大模型",而是:数据补齐、仿真打通、护栏可证明、世界模型能用,四件事同时到位,通用才真正可期。
五、收尾:回到那杯水
还记得开篇那杯水吗?人形机器人转身、俯身、伸手、稳稳端起,全程不到 10 秒,水没洒一滴。第一篇文章里我们说,这 10 秒背后是一场极其密集的计算接力;第十篇的今天,我们可以给这句开场一个更完整的注脚——
这杯水之所以端得稳,不是因为模型"最聪明",而是因为:它在毫秒内跑完了感知到执行的每一环(第 7 篇),在边缘芯片上够小够省(第 3、5 篇),在临界工况下被护栏兜住(第 9 篇),而未来,它还会在脑中先推演一遍再伸手(世界模型)。
专题里我们一直主张一句话:具身智能不是"更聪明的模型",而是"能在毫秒内、在本体上、可控地跑起来的模型"。端侧大模型把"脑"贴到身体上,世界模型把"想"提前到"动"之前——下一个十年,那杯水大概会被端得更稳、更从容。但无论模型怎么进化,推理指标、安全临界、那三道护栏,永远是你敢让它动手的理由。
这是「具身智能·推理部署」的第十篇,也是收官。从一杯水出发,我们走完了地基。剩下的路,交给下一个十年的工程师们——也包括读到这里、已经看懂这套逻辑的你。
读后小测
3 句话复述
1. 端侧大模型(承接第 3 篇量化、第 5 篇边缘部署)让模型越跑越小、越能装进本体,端侧多模态(视觉 + 语言 + 动作统一)是明确趋势,近况方向包括端侧 VLA 与手机 / 本体直接跑多模态模型。 2. 世界模型把推理范式从"预测下一个 token / 动作"升级为"预测下一个世界状态",让机器人在脑内先推演多种可能再行动,呼应第 4 篇的 TBT 安全临界与"肌肉记忆",大幅砍掉真实试错带来的延迟—安全代价。 3. 把 10 篇串成"还差几步"的判断地图:数据、成本已够用但不够好(近期可啃),仿真泛化与安全证明是中后期硬骨头,世界模型成熟度是决定"通用"能否到来的关键拼图——四件事同时到位,通用才真正可期。
1 件动手小事
今晚做一个"世界模型"的纸上推演:拿一张纸写下一个你常做的动作(比如过马路前看车流),左边列"如果直接冲过去,可能的几种结果",右边列"如果先在脑中模拟三秒:车距、车速、绿灯剩余,再决定走还是等",对比两边你真正付出的代价(时间、风险)。你会发现:人在关键时刻本来就在跑一个简易"世界模型"。把这个体感记住,再回看本篇那张范式对比图——你会立刻明白,为什么让机器人"先想清楚再动",省下的不只是算力,更是撞墙和失稳的代价。