从云端到本体:具身模型的边缘部署实战
第 4 篇结尾我们放话了:指标看清、危险看清,下一篇直接"搬箱子"——把瘦身好的模型从云端搬进机器人身体。这篇就真的动手了。
不过动手之前先泼盆冷水:你电脑里那个跑得飞起的云端大模型,其实根本塞不进机器人。
一、云端那台"无限电"的机器,为什么塞不进机器人身体
先想清楚云端大模型到底"住"在哪。它待在数据中心里:接入市电电网,想用多少电用多少;机柜后面是一排工业空调,热了就吹;整面墙的机架,想堆多大堆多大。用大白话说——云端享有"无限电、无限散热、无限空间"三件套。
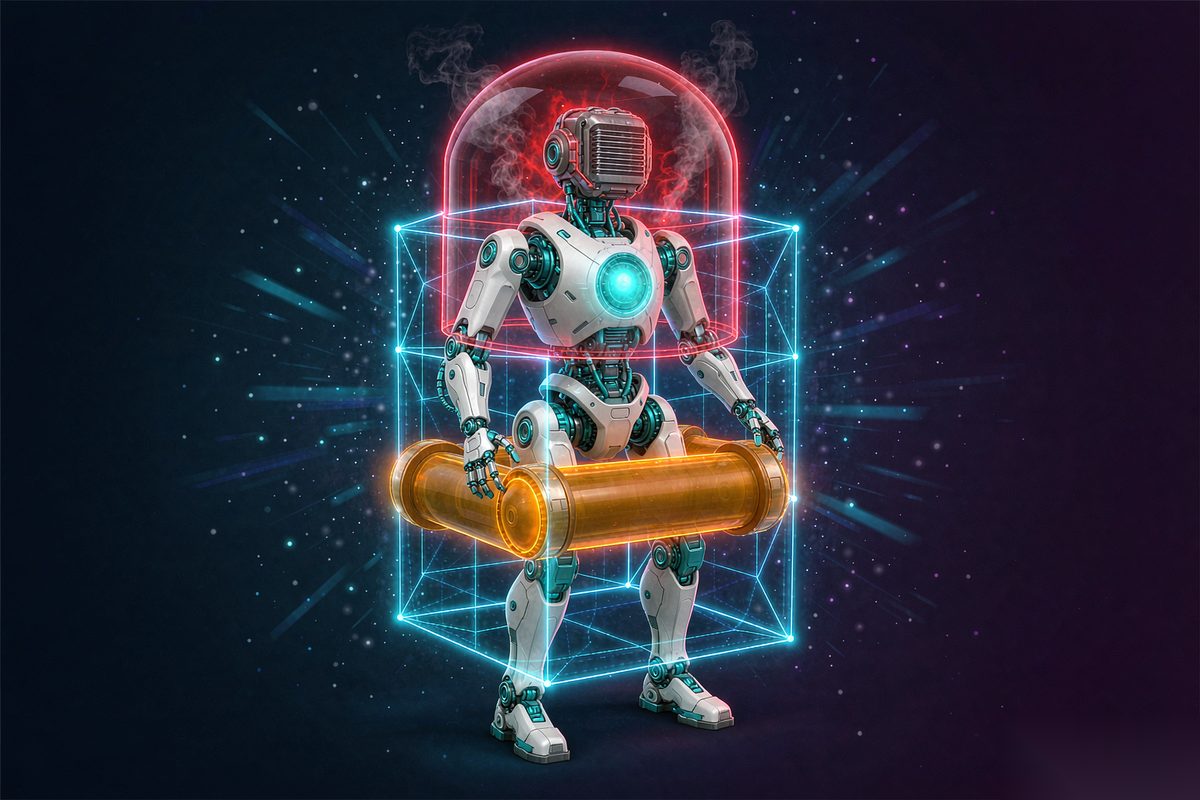
现在把同一个模型请进机器人身体,三件套瞬间变成三道枷锁:
- 功耗枷锁(电池):机器人靠一块电池活着,总功率只有几十瓦的预算,还得分给电机、传感器、通信。云端那种几百瓦、上千瓦的"胃口",身体供不起。
- 散热枷锁(密闭腔体):机器人身体是密闭的小腔体,不像机房有排风扇对着吹。芯片一发热,热量散不出去就"中暑"降频,甚至宕机。
- 体积枷锁:本体里塞满了电机、齿轮、电池,留给"脑子"的物理空间就巴掌大。云端那一整柜服务器,连个角都塞不下。
打个比方:这就像你非要把一整个带空调的机房,塞进一个背包里背着走——电不够、热散不掉、也装不下。结论很自然:模型不能"原样"待在云端等机器人来问,得搬到机器人就近的地方,甚至直接搬进本体。这就是"边缘部署"。
二、边缘芯片三选一:把"整台电脑"缩进一块板子
"边缘"听着玄,其实说的就是把算力从远方机房,挪到离机器人最近的那块板子上。它和云端最大的不同:单芯片就把 CPU、GPU(或 NPU 这类专用计算单元)全集成在一起,功耗只有"几十瓦"量级,巴掌大,能直接塞进机器人身体。
市面上有几类主流选手,通俗认识一下(不堆参数,只记定位):
- NVIDIA Jetson Orin:机器人圈子的"老熟人",最大的优势是 CUDA 生态成熟——前面几篇聊的量化、推理框架,到了它身上基本无缝衔接,工具链现成。
- 地平线(旭日系列):国产车规/机器人芯片,原本在自动驾驶上练出来的本事,现在也大量用到机器人。特点是"国产 + 面向实时控制优化"。
- 昇腾边缘模组:华为的国产算力方案,同样把训练/推理的国产链路打通,适合想走自主技术栈的团队。
它们的共同点一句话总结:都是"把整台电脑缩成一块低功耗小板子"的工程魔法,让你能在身体里装一个够用的"本地大脑"。
三、模型瘦身三板斧:让大模型"挤"进小芯片
光有芯片还不够,模型本身也得"瘦"。第 3 篇我们讲过量化(FP8/INT4/GGUF)是让模型瘦身又不太掉精度的关键手段;本篇把它接上"边缘"这个新舞台,再补两板斧,凑成三板斧。
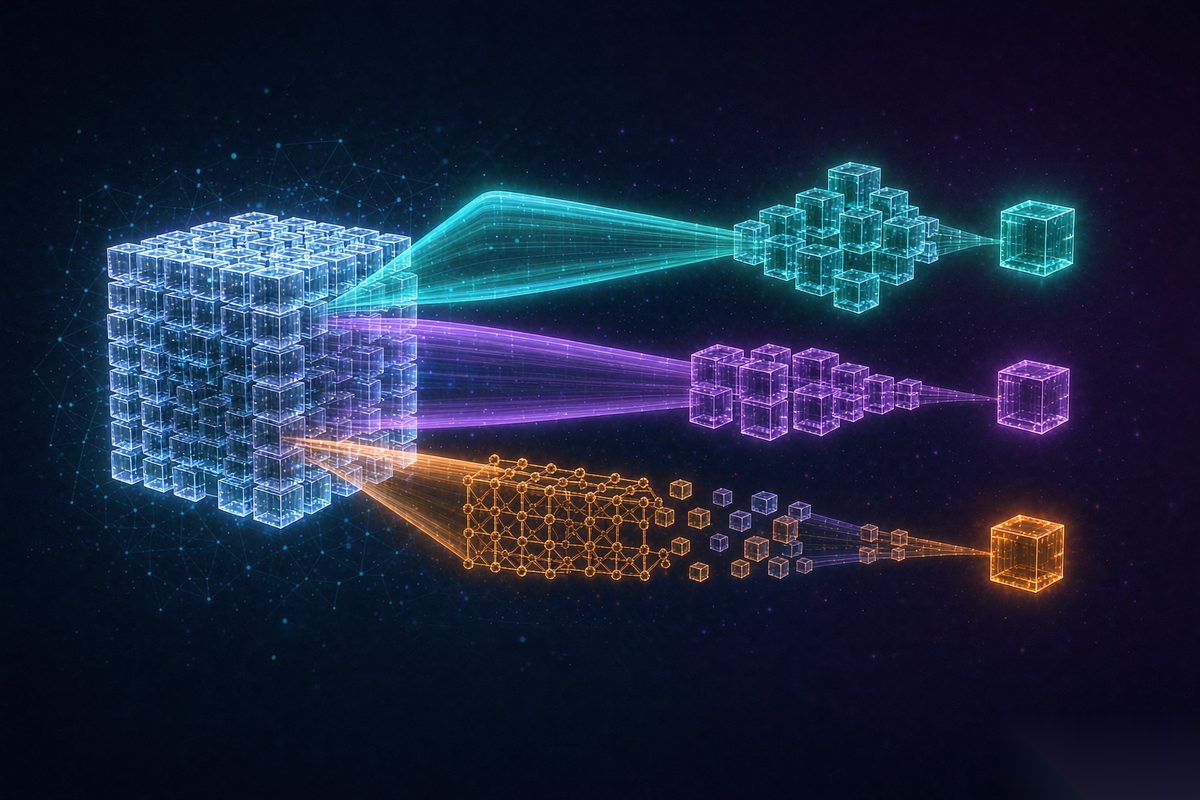
- 第一板斧·量化(INT8 / INT4):复习一下——模型权重原本用 FP16/FP32(高精度浮点)存,量化就是把它"降精度"成整数。INT8(8 位整数)是边缘最常用、精度掉得少的稳妥选择;INT4(4 位)更狠,体积能再砍一大半,但越狠越容易"掉精度"——本来能认对的动作,可能就开始出错。在边缘端,精度—速度—体积的权衡比云端极端得多,因为每一瓦、每一兆字节都珍贵。
- 第二板斧·蒸馏(知识蒸馏):类比"师傅带徒弟"。让一个已经很聪明的大模型(师傅)去教一个小模型(徒弟):徒弟不背师傅的全部参数,只学师傅"怎么想问题"的精髓。结果就是,小模型在边缘的小芯片上跑得动,又保留了大部分能力。这是用"训练时的额外功夫",换"部署时的轻松跑起来"。
- 第三板斧·稀疏化:模型里其实有大量权重"约等于 0",对结果几乎没贡献。稀疏化就是把这些接近零的权重"剪"掉、计算时直接跳过——模型变稀疏了,要算的数少了,自然算得更快、也更省电。像一本书里划掉所有废话,剩下的干货翻起来更快。
三板斧常常组合使用:先蒸馏出小模型,再量化压精度,顺手稀疏化剪掉冗余,最后塞进边缘芯片。
四、同一模型,云端 vs 边缘:用功耗和延迟换"把脑子装进身体"
三板斧之后,同一个 VLA(Vision-Language-Action,视觉-语言-动作模型——也就是能"看画面、懂指令、出动作"的机器人专用大模型)就既能跑在云端、也能跑在边缘了。两者代价差多少?
⚠️ 说明:本专题目前没有真实自测数据,下面用清晰的量级示意口吻讲,便于建立直觉,非精确实测:
- 云端:算力管够,延迟能做到"几十毫秒"级;代价是功耗"几百瓦到上千瓦"——它身后连着整个机房的电力系统。
- 边缘:算力有限,延迟可能升到"百毫秒"级(慢了,但还记得第 4 篇说的,闭环靠的是稳稳压在临界线内,而不是无限快);换来的是功耗被压到"几十瓦",和机器人电池同量级。
这笔账怎么算?边缘是用"功耗和延迟"的代价,换来了三件云端给不了的东西:
1. 把脑子装进身体——不再需要把画面传回千里外的机房等回复,本地就能决策; 2. 摆脱网络依赖——断网、弱网、信号遮挡都不怕,不会"想一半卡住"; 3. 实时闭环——数据不出本体的小闭环里转,响应更可控、更安全。
一句话:云端的快是"远方的大脑",边缘的慢是"贴身的大脑"。机器人要的是后者。
五、动手链路串起来:从云端大模型到本体闭环
把前面几块拼起来,一条完整的"下放"链路就清楚了:
左边是原本"住机房"的大模型,中间两关把它压进小芯片,右边就是第 4 篇讲过的控制闭环:感知当前帧 → 生成动作 → 执行 → 状态回采,一遍遍转。
模型瘦好了、硬件就位了,链路也通了。但还有一个绕不开的问题:RT-1/RT-2、OpenVLA、π0 这些主流 VLA 模型,到底谁真能在边缘小芯片上跑起来、谁只是"论文里很美"? 下一篇,我们横评几个主流 VLA 模型,看它们在边缘端的真实可部署性。
那是真正的"谁行谁上"的硬碰硬。
读后小测
3 句话复述
1. 云端大模型享有"无限电、无限散热、无限空间",而机器人受功耗(电池)、散热(密闭腔体)、体积三重枷锁,所以必须把模型搬近身体甚至装进本体,这就是"边缘部署"。 2. 边缘芯片(Jetson Orin / 地平线旭日 / 昇腾模组)的共同点是单芯片集成 CPU+GPU/NPU、功耗几十瓦、巴掌大能塞进身体;模型瘦身三板斧是量化(INT8 常用、INT4 更狠易掉精度)、蒸馏(师傅带徒弟)、稀疏化(剪掉近零权重)。 3. 同一 VLA 模型云端延迟几十毫秒但功耗几百瓦以上,边缘延迟升到百毫秒级但功耗压到几十瓦;边缘用功耗和延迟换来了"把脑子装进身体、摆脱网络依赖、实时闭环"——机器人要的是贴身的大脑。
1 件动手小事
今晚打开一个能跑本地模型的工具(比如 Ollama),故意把同一个模型分别用 Q8(接近 INT8)和 Q4(接近 INT4)两种量化加载,感受一下体积小了多少、回答有没有变"笨"一点;再想象一下,这台小电脑如果装在机器人胸口,它在断网时还能不能自己"看一眼、想一下、动一下"。把"边缘 = 贴身大脑、慢一点但稳得住"这个体感记牢,下一篇我们横评 RT-1/RT-2、OpenVLA、π0 这几个 VLA 模型在边缘到底谁跑得动时,你会立刻懂为什么第一步就得先瘦身。